誤差逆伝播法とは、AIが「予測と正解のズレ」をもとに、間違いを減らすように内部の設定を調整する学習方法である。
ニューラルネットワークの学習に使われ、ディープラーニングを支える重要な技術の一つである。
たとえば、AIに猫の写真を読み込ませて「この画像は猫か?」と質問させながら学習させる。
AIが「猫ではない」と間違えたら、正解との差を計算し、「どこをどのくらい変えれば、次は正解に近づけるか」を計算する。そして、その結果をもとにAI内部の設定を少しずつ調整する。
この作業を大量のデータで繰り返すことで、AIは徐々に正しい予測ができるようになる。
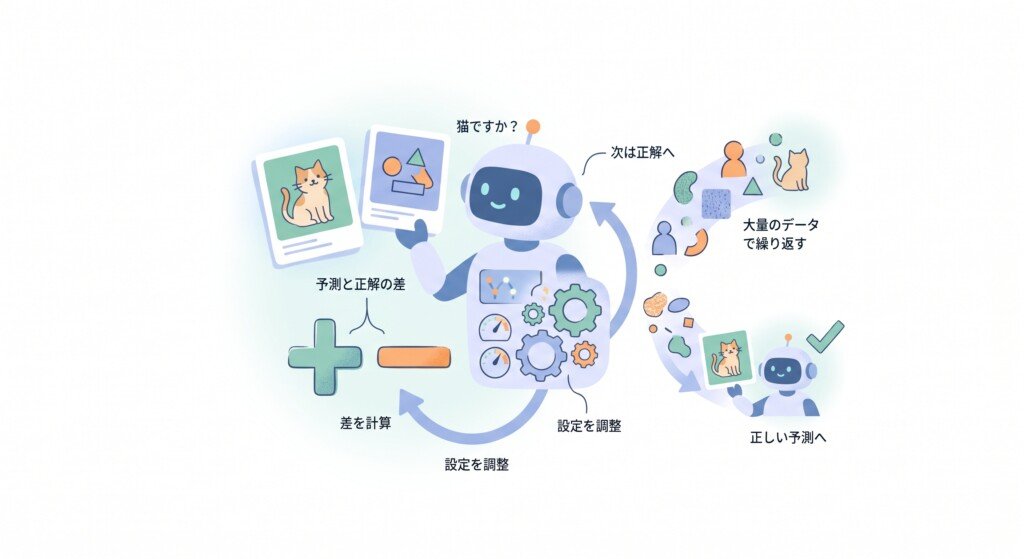
AIは予測と正解の差をもとに設定を調整して、学習する
AIは間違いながら学習する
AIの学習は、人間の「答え合わせと復習」に似ている。
たとえば、猫と犬の画像を見分けるAIなら、次のようなサイクルを繰り返す。
- 予測する:「これは猫」と判断する
- 答え合わせをする:実際の正解と比べる
- 間違いをさかのぼる:どの部分の判断が間違いにつながったのかを計算する
- 調整する:AI内部の設定を少し変える
この「間違いをさかのぼって調整する」仕組みが、誤差逆伝播法である。
なぜ「逆」伝播なのか?
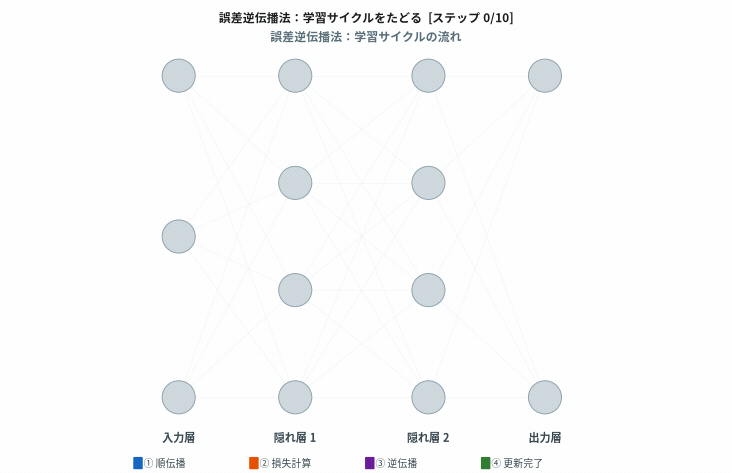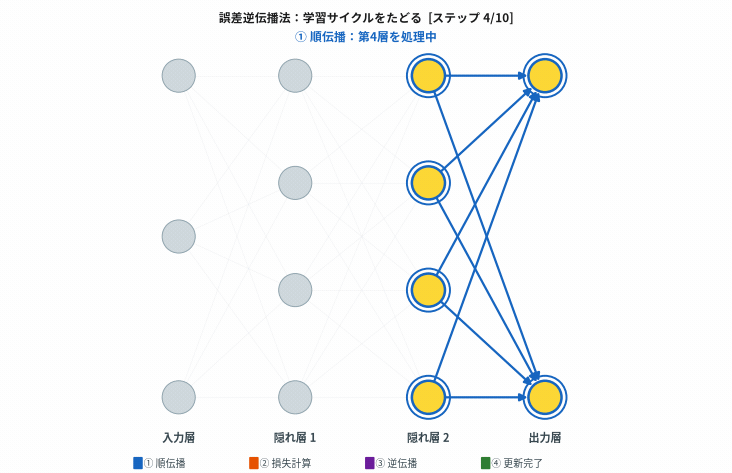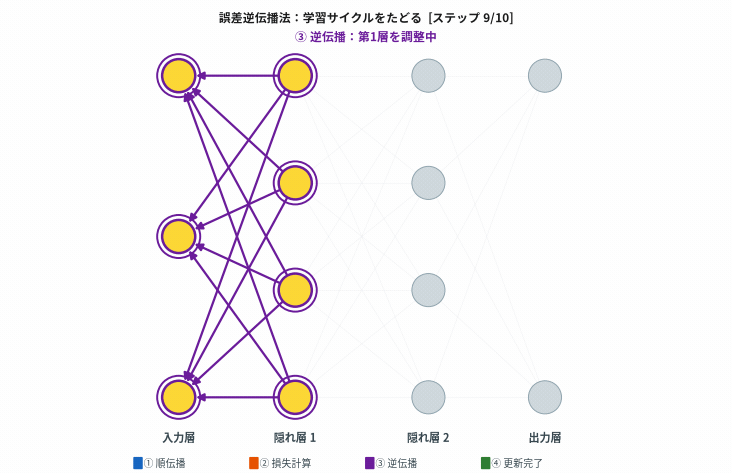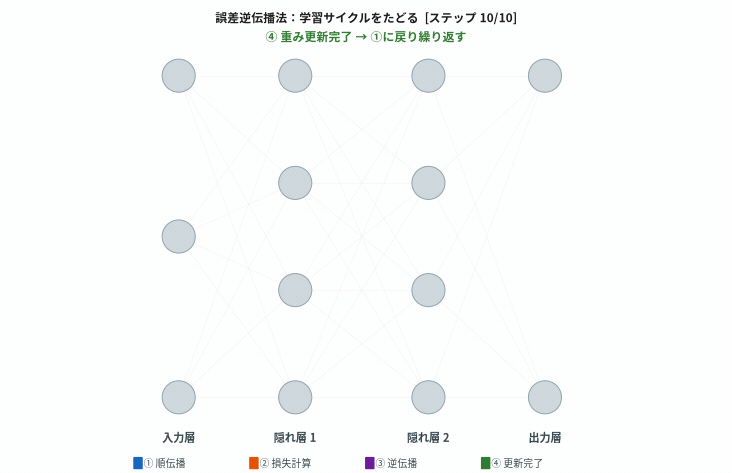
ニューラルネットワークには、情報の流れる方向が2つ存在する。
| 種類 | 方向 | 目的 |
|---|---|---|
| 順伝播 | 入力 → 出力 | データから予測する |
| 逆伝播 | 出力 → 入力 | 間違いの影響をさかのぼって、調整する場所を計算する |
たとえば、AIが画像を見て「猫」と判断する場合、情報は入力された画像からネットワークを順番に通り、最後に「猫」という予測が出る。
その予測が間違っていた場合は、結果から逆向きにたどりながら、どの部分をどのくらい調整すればよいかを計算する。
これが「逆伝播」と呼ばれる理由である。
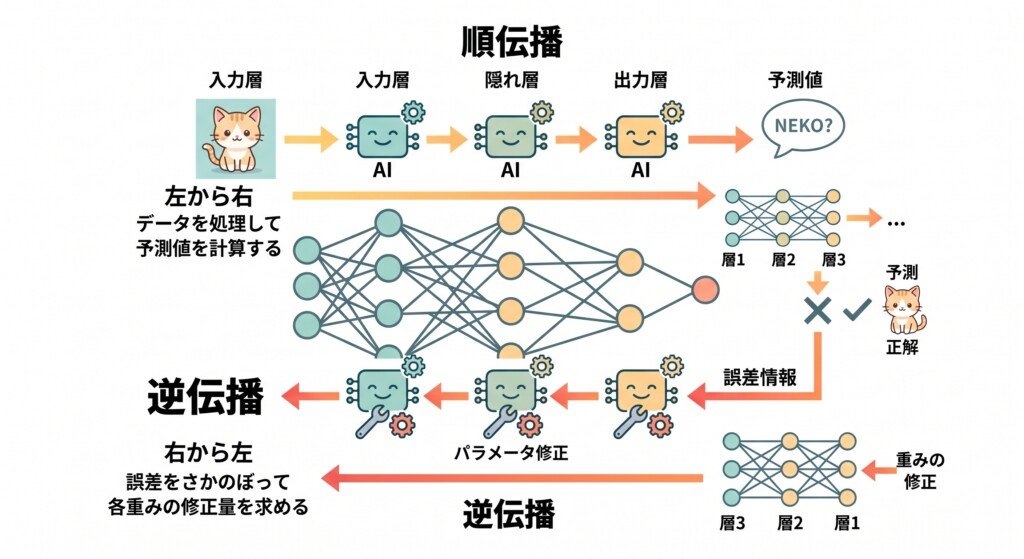
順伝播と逆伝播
「重み」を調整して学習する
ニューラルネットワークには、入力された情報をどの程度重視するかを決める「重み」という設定が大量にある。
たとえば、犬と猫を見分けるときに、
- 耳の形をどのくらい重視するか
- 毛の特徴をどのくらい重視するか
- 顔の形をどのくらい重視するか
といった判断に関わる設定を持っているイメージである。
AIが間違えたとき、誤差逆伝播法を使ってどの重みをどのくらい変えれば誤差を減らせるかを計算する。
この調整を何度も繰り返すことで、AIはデータの特徴を少しずつ学習していく。
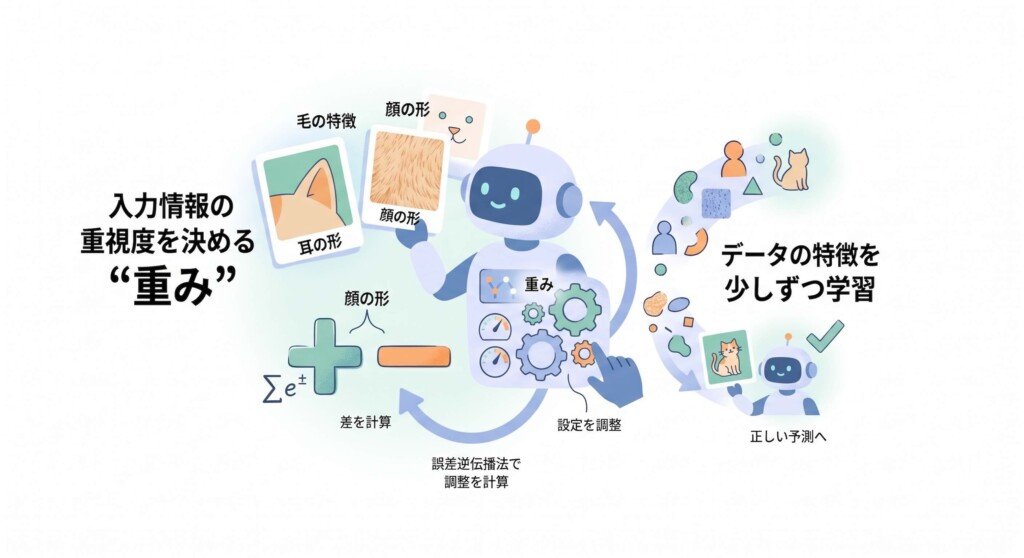
入力情報の重要度を決める重み
連鎖律で大量の設定を効率よく調整する
ニューラルネットワークには非常に多くの重みがある。そのため、一つずつ試して調整するのは現実的ではない。
そこで使われるのが、数学の連鎖律(チェインルール)である。
簡単に言えば、「最終的な間違いに、それぞれの設定がどのくらい影響したか」を効率よく計算する方法である。
これによって、何層にも重なった複雑なニューラルネットワークでも、多数の重みを効率よく調整できる。
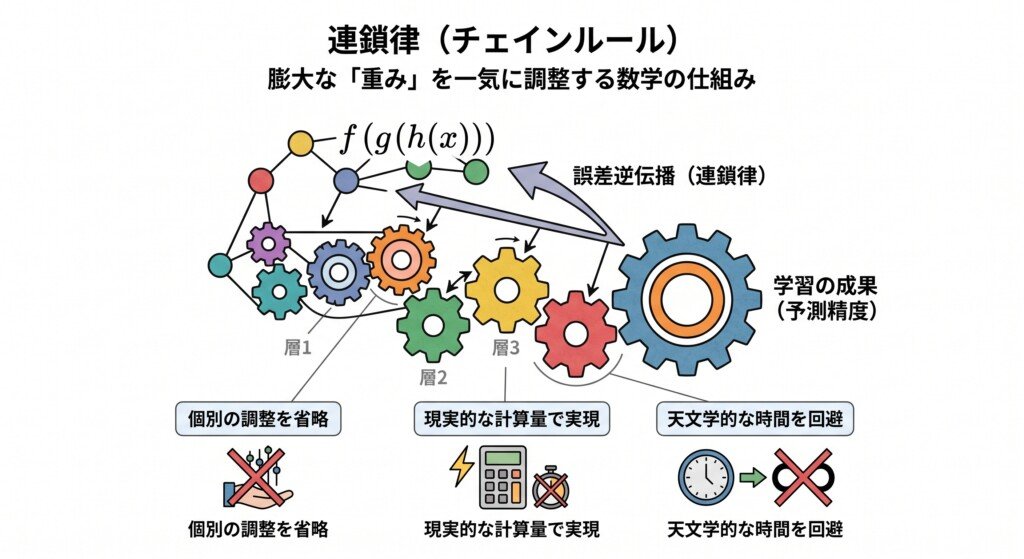
連鎖率のイメージ
提唱・開発の歴史
誤差逆伝播法は、ひとりの研究者だけによって突然生まれた技術ではない。その考え方は、自動微分・最適化・制御理論などの積み重ねの中で形づくられてきた。
理論的な基盤のひとつとして知られるのが、フィンランドのコンピュータ科学者、
セッポ・リンナインマー氏
https://linnainmaa.1g.fi/seppo/etusivu/seppo_en.htmlより引用
その後、ニューラルネットワークの学習法として広く注目される契機になったのが、
-
-
デビッド・ラメルハート氏
https://ja.wikipedia.org/wiki/デビッド・ラメルハートより引用
-
-
ジェフリー・ヒントン氏
-
-
ロナルド・J・ウィリアムス氏
https://www.khoury.northeastern.edu/a-tribute-to-ron-williams-khoury-professor-and-machine-learning-pioneer/より引用
UXデザインとの関係
誤差逆伝播法は、UXデザインの手法ではない。しかし、AIを使ったサービスを設計するうえで、AIは「最初から正解を知っている」のではなく、大量のデータから間違いを減らすように学習していることを理解しておくことは重要である。
たとえば、次のようなAI機能の多くは、誤差逆伝播法を使った機械学習モデルによって支えられている。
画像検索・商品レコメンド
画像の特徴を学習し、「似ている商品」を探したり、ユーザーが興味を持ちそうな商品を予測したりする。
自動字幕・文字起こし
音声と正しい文章のデータを使って学習し、音声を文字に変換する精度を高める。
文章の予測・返信候補
過去の文章データなどを学習し、次に入力されそうな言葉や返信内容を予測する。
パーソナライズ
ユーザーの閲覧や購入などのデータをもとに、「次に興味を持ちそうな情報」を予測し、表示する内容や順番を最適化する。
このように、誤差逆伝播法はユーザーが直接触れる機能の裏側で、AIの予測精度を高めるために使われている。
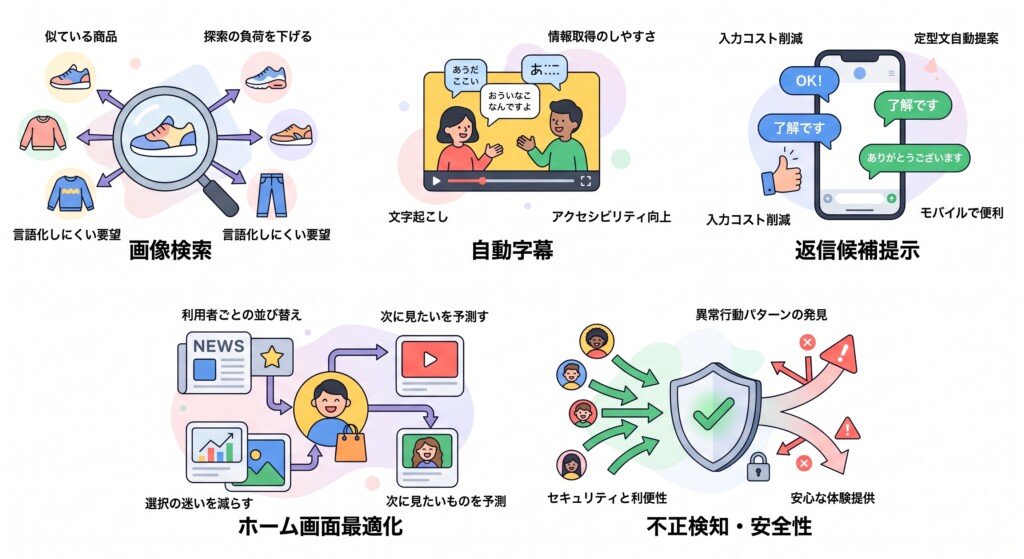
誤差逆伝播法とUX設計の関係
デザイナーが考慮すべきこと
誤差逆伝播法によってAIの精度を高めても、AIが常に正しい判断をするとは限らない。
特に注意したいのが次の2点である。
学習データの偏り
AIは、学習に使ったデータの影響を受ける。
もし学習データに偏りがあれば、その偏りをAIが学習してしまう可能性がある。そのため、AIの精度だけでなく、どのようなデータを使って学習したのかも重要になる。
AIが間違えたときの設計
AIの判断が間違う可能性がある以上、UXでは「AIが正解を出すこと」だけを考えるのではなく、間違えたときにユーザーが修正できる仕組みも必要である。
たとえば、
- 「違います」と訂正できる
- 結果を編集できる
- 別の候補を選べる
- 重要な判断は人間が最終確認する
といったリカバリーの導線を用意する。
AIの学習方法を理解することは、AIを過信せず、「間違うことを前提としたUX」を設計することにもつながる。
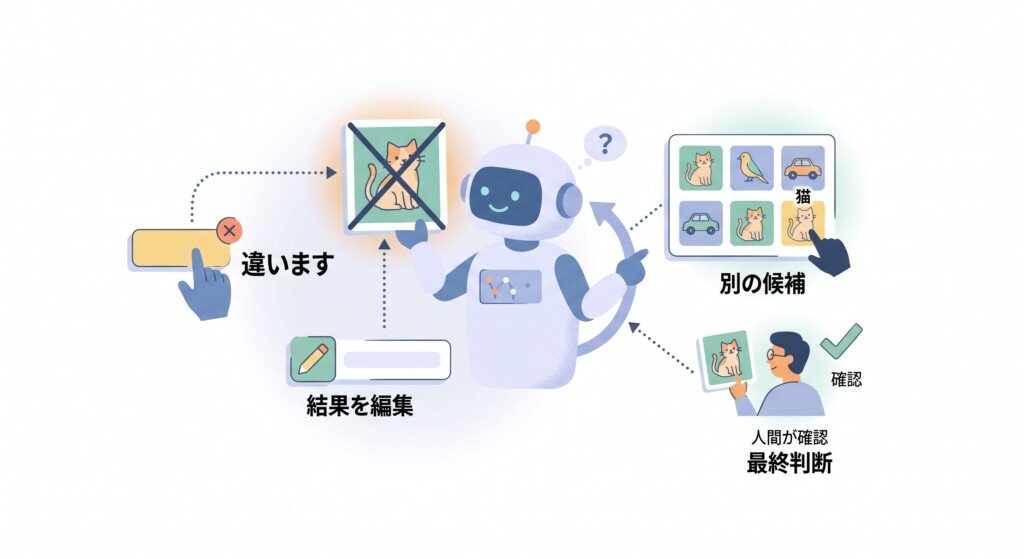
AIが間違った判断をした時にリカバリーできるようにする
関連用語
ディープラーニング
トランスフォーマー
勾配降下法
参考リンク
- David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams, “Learning representations by back-propagating errors”, Nature, vol. 323, pp. 533–536, 1986
- 3Blue1Brown, “What is backpropagation really doing?” (2017 )
- http://neuralnetworksanddeeplearning.com/chap2.html
- Stanford CS231n, Backpropagation, Intuitions